SPEC // 01
多头潜在注意力 (MLA)
创新键值低秩联合投影压缩,推理显存占用降低至原有三分之一,保持精准长程上下文关联度。
 DeepSeek
OFFICIAL
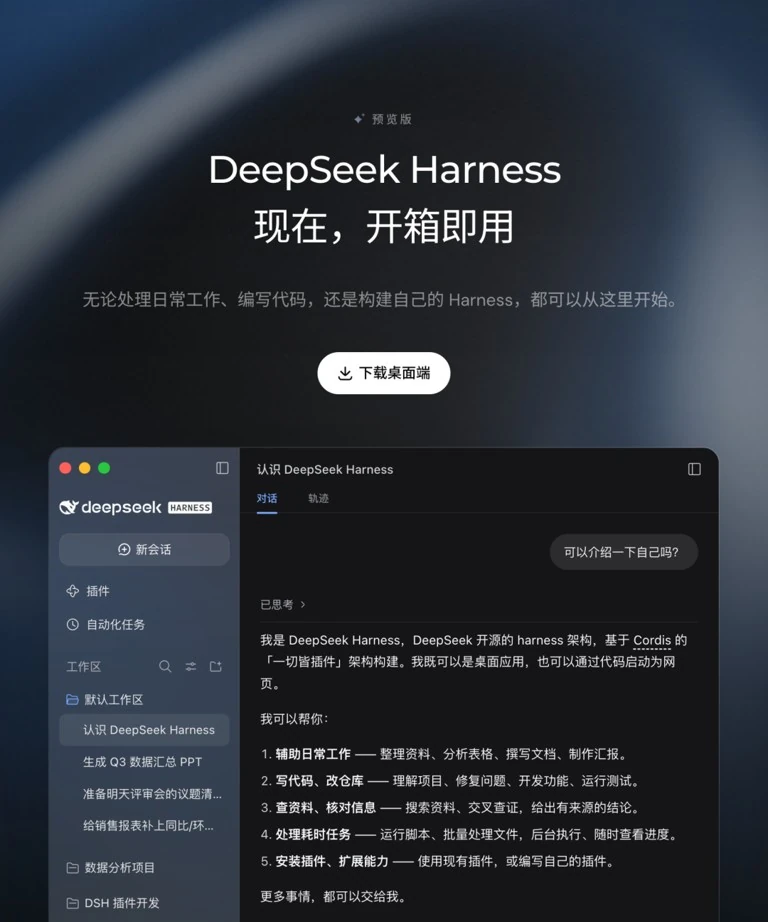
作为新一代官方人工智能在线站,全面聚合免安装直达的 DeepSeek网页版入口、高性能 DeepSeek api开放平台 以及开源双盲基准 DeepSeek Harness。所有模型规格与阶梯参数均以文字和表格单元格清晰呈现,提供透明可复现的技术保障。
创新键值低秩联合投影压缩,推理显存占用降低至原有三分之一,保持精准长程上下文关联度。
无需冷启动海量人工标注,完全在数理规则沙箱中自发涌现反思验证、假设纠错与深度推理能力。
总参数达 671B,每个 Token 动态激活 37B 专家权重,在单次前向传播中达到顶尖推断性价比。
原生支持上百页学术文献与大型代码库分析,长序列推导中变量命名与数理符号前后完全统一。
深入分析复杂工程拓扑结构,自动定位内存泄漏与死锁,给出严密的单元测试与重构方案。
支持 IMO 级别复杂几何代数推导,在思维链中呈现详尽引理建立过程与反证法归谬过程。
批量解构数百页法务条款、竞业限制与财务审计报表,精准梳理穿透股权关系与合规风险。
将高频行情盘口信号与时序宏观因子编写为策略算法,在多空模拟对冲环境中展开严谨推演。
具备高可靠的函数调用与工具使用能力,自主规划多阶段任务序列,与外部沙箱无缝交互。
提供完整开源模型权重与多规格量化蒸馏版本,支持在局域网内完全离线部署运行。
显式长思维链深度推理模型
高性能 MoE 通用对话底座
| 模型代号 | 基础架构 | 总参数量 | 单 Token 动态激活 | 最大上下文 | 前缀缓存计费 |
|---|---|---|---|---|---|
| DeepSeek-R1 | MLA + Pure RL | 671 Billion | 37 Billion | 128,000 Tokens | 命中 ¥0.014 / 未命中 ¥0.14 |
| DeepSeek-V3 | 256 专家 MoE | 671 Billion | 37 Billion | 128,000 Tokens | 命中 ¥0.014 / 未命中 ¥0.14 |
| DeepSeek-70B | Dense 蒸馏微调 | 70 Billion | 70 Billion | 128,000 Tokens | 开源可商用权重免费分发 |
无需学习复杂的私有接口规范,只需替换调用网关与密钥,即可将现有的生产系统平滑迁移至 Deep Seek 高性价比算力网格。
在帮助中心或开发者工作台申领密钥,系统自动启用基于 64-Token 对齐的前缀缓存加速通道。
将现有 OpenAI SDK 中的 base_url 修改为官方调度域名,model 设定为 deepseek-reasoner 或 deepseek-chat。
响应对象中内建 reasoning_content 字段,前端界面可原生渲染出推理逻辑树与每步思考判定细节。
针对个人研究、团队协作以及底层性能复现的不同需求,DeepSeek 提供多维度触达路径。
所有测试集输入均在无网络访问的独立 Docker 沙箱中执行,杜绝模型在测试阶段通过外部工具拉取答案,确保所有推理步骤均源于内部认知表征。
不使用大模型给大模型打分的主观方式,而是直接运行代码单元测试与符号计算解析器,唯有通过全部 Assert 断言方能判定为成功通过。